AIエージェント開発を外注する前に確認すべき権限設計と検収項目
問い合わせ対応、営業資料作成、社内ナレッジ検索、請求確認、プロジェクト進捗整理などをAIエージェントに任せたい企業は増えています。 本記事では、AIエージェント開発を外注する前に、発注者が確認すべき権限設計、認証認可、承認フロー、監査ログ、検収項目を整理します。
目次
結論要約
AIエージェント開発を外注するときは、モデル性能より先に、AIが読める情報、書き込める情報、実行できる操作を分ける必要があります
「読む」「下書きする」「承認後に実行する」「自律実行する」を同じ発注範囲に入れると、検収で安全性を確認しにくくなります
認証認可、接続先、ユーザー権限、監査ログ、停止条件は、ベンダー任せではなく発注者側の検収項目に入れるべきです
AIに権限を渡しすぎると、誤回答だけでなく、誤更新、権限外情報の参照、承認前の業務実行が起き得ます
Phinxは、業務整理、データ基盤、既存システム連携、AI-native開発を一体で見られるため、AIエージェントを業務に落とし込む設計から支援できます
AIエージェント外注で最初に決めること
AIエージェント開発を外注するとき、最初に決めるべきなのは、どのモデルを使うかではありません。
どの業務で、誰の代わりに、どこまで実行させるかです。
同じ「AIエージェント」でも、社内文書を探して回答案を出すだけのものと、SaaSへログインしてデータを更新するものでは、必要な権限と検収基準がまったく違います。
たとえば、営業担当の提案書作成を支援するエージェントであれば、過去提案書、商品資料、顧客情報、価格表へのアクセスが問題になります。
問い合わせ一次対応であれば、FAQ、過去チケット、顧客契約、返信文面の承認が問題になります。
経理や請求確認であれば、会計システムや請求SaaSを読むだけなのか、支払ステータスまで更新するのかでリスクが変わります。
外注先は、技術的には多くの接続を実装できます。
しかし、発注者が業務上の許可範囲を決めないまま実装に入ると、「便利なデモ」はできますが、本番運用の承認で止まりやすくなります。
発注前には、業務、利用者、接続先、操作範囲、承認者、ログの保管責任を分けて言語化してください。
発注範囲は成果物ではなく業務行為で切る
AIエージェント外注では、「チャット画面を作る」「Slackから使えるようにする」といった成果物だけで発注範囲を決めると、検収が弱くなります。
発注者が見るべきなのは、AIが業務上どの行為を担うかです。
読むだけなら、権限外の情報を検索しないことが主な検収対象です。
下書きまでなら、根拠、引用元、表現の責任範囲を見ます。
承認後に実行するなら、誰が承認し、承認内容と実行内容が一致しているかを確認します。
自律実行するなら、金額、顧客、対象データ、時間帯、失敗時の停止条件まで必要になります。
この切り分けがないまま「業務を自動化したい」とだけ伝えると、ベンダーは画面やプロンプトを作れても、発注側は検収時に何を合格とするか判断できません。
AIエージェントの発注範囲は、機能一覧ではなく、業務行為と権限レベルで切る必要があります。
業務ユースケースごとに権限を分ける
AIエージェント化しやすい業務はあります。
ただし、外注しやすい業務と、AIに強い権限を渡してよい業務は同じではありません。
発注前には、業務ユースケースごとに「読む」「下書き」「承認後実行」「自律実行」を分けます。
業務ユースケース | 初期導入で任せやすい範囲 | 検収で見る点 |
|---|---|---|
問い合わせ一次対応 | FAQ検索、回答案作成 | 最新FAQを参照し、送信前に人が承認できるか |
営業資料・提案書作成 | 過去資料検索、構成案作成 | 顧客別条件や価格を勝手に確定しないか |
社内ナレッジ検索 | 規程・マニュアル検索 | ユーザー権限外の文書を回答に混ぜないか |
請求・経理確認 | 請求状況の照会、差分検出 | 更新操作や支払処理が承認制になっているか |
プロジェクト進捗整理 | チケット要約、リスク抽出 | タスク変更や通知送信の範囲が制限されているか |
この表で重要なのは、業務名ではなく権限の段階です。
同じ問い合わせ対応でも、回答案を出すだけなら比較的始めやすい一方、顧客へ自動送信する場合は誤送信や情報漏えいのリスクが上がります。
同じ経理確認でも、差分を検出するだけなら補助業務ですが、支払や請求ステータスを更新するなら承認フローが必要です。
強い権限は段階的に渡す
AIエージェントに最初から強い権限を渡す必要はありません。
実務では、まず読み取り専用で始め、次に下書き、次に人間承認付きの実行へ広げる方が安全です。
この段階設計があると、PoCから本番運用へ移るときに、権限、ログ、責任分界を一つずつ確認できます。
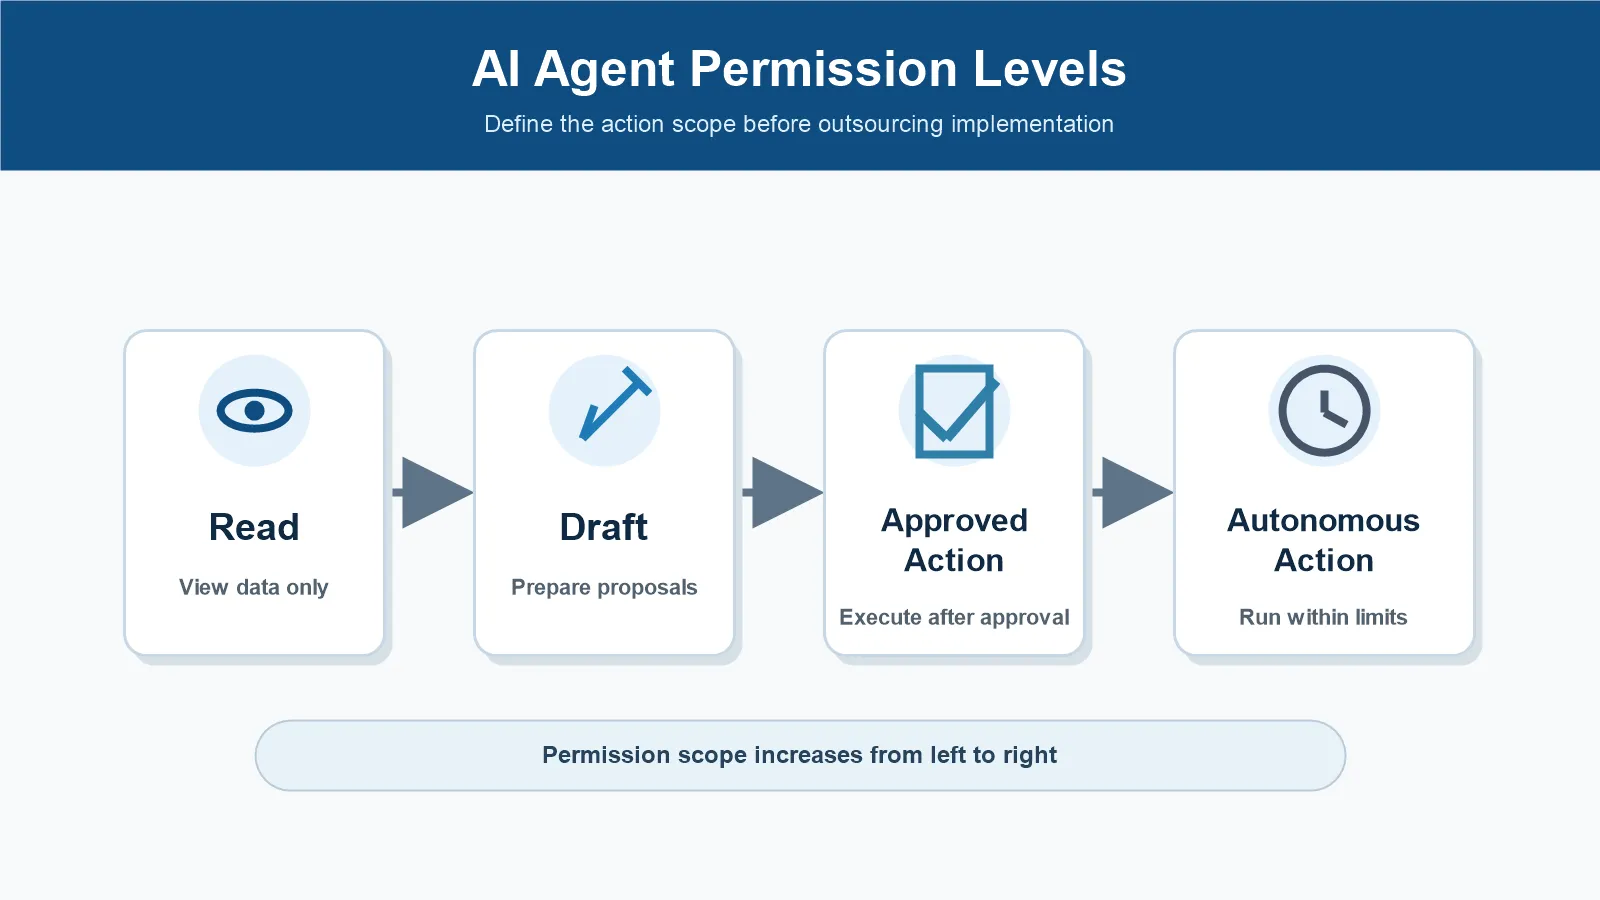
図では、AIエージェントに渡す権限を4段階で示します。
Read、Draft、Approved Action、Autonomous Actionの順に権限が強くなります。
発注者は、いま外注したい業務がどの段階にあるかを先に決めてから、ベンダーへ実装相談をするべきです。
外注前に確認する認証認可と接続範囲
AIエージェントが業務で役に立つほど、社内文書、SaaS、データベース、業務APIと接続します。
そのときに必要になるのが、認証認可と接続範囲の確認です。
発注者がここを把握していないと、検収時に「動いたこと」は見えても、「誰の権限で、どこまで操作したか」が見えません。
2026年7月28日のModel Context Protocol仕様では、MCPがstateless core、header-based routing、authorization hardeningなどを含む形で更新されました。
MCPのロードマップでも、agent identityやenterprise-ready securityは重点領域として扱われています。
つまり、AIエージェントが外部ツールを呼び出す仕組みが整うほど、権限、認証、ルーティング、監査を設計する重要性も上がります。
発注者が細かな実装仕様まで理解する必要はありません。
ただし、少なくとも次の問いには答えられる状態で発注する必要があります。
AIエージェントは、個人アカウントで動くのか、専用のサービスアカウントで動くのか
ユーザー本人の権限を引き継ぐのか、エージェント用の権限を別に与えるのか
接続するSaaS、データベース、API、ファイルストレージは何か
読み取り、作成、更新、削除のどこまで許可するのか
顧客情報、人事情報、契約情報、財務情報などをどう制限するのか
権限変更や接続先追加を誰が承認するのか
Microsoft Learnでは、MCPサーバーをMicrosoft Entra IDで保護する例として、MCPクライアントが対象リソースを指定してアクセストークンを要求し、サーバー側がトークンを検証してからツールを実行する流れを説明しています。
また、OAuthのスコープやアプリロールを使い、操作ごとにアクセス範囲を細かく分ける考え方も示されています。
発注者は実装手順そのものではなく、このようにAIエージェントの操作が通常の業務APIと同じく認証認可の対象になっているかを確認してください。
接続先ごとに権限表を作る
外注前には、接続先ごとの権限表を作ると確認しやすくなります。
SaaS名、利用目的、参照データ、実行操作、認証方式、承認者、ログ保管場所を一覧にします。
この表は、ベンダーに渡すだけでなく、社内の情報システム部門やセキュリティ担当との合意にも使えます。
確認項目 | 発注者が決めること | 検収時の確認 |
|---|---|---|
接続先 | 使うSaaS、API、文書管理システム | 未承認の接続先がないか |
認証方式 | 個人権限、サービスアカウント、SSO | 誰の権限で操作したか追えるか |
操作範囲 | 読み取り、作成、更新、削除 | 許可外の操作が拒否されるか |
データ範囲 | 部門、顧客、案件、機密区分 | 権限外データを回答に混ぜないか |
変更管理 | 権限追加、接続先追加の承認者 | 変更履歴が残るか |
この表を作らずに外注すると、発注者は「AIが便利に動く」ことだけを見てしまいます。
本番運用で問題になるのは、便利さではなく、許可していない情報に触れていないか、許可していない操作をしていないかです。
検収で見るべき承認フローと監査ログ
AIエージェントの検収では、回答精度だけを見ても足りません。
特に、メール送信、チケット更新、CRM更新、請求ステータス変更、ファイル共有、外部通知などの書き込み操作がある場合は、承認フローと監査ログを確認します。
OpenAIのWorkspace Agents for Enterprise and Businessでは、リスクのあるワークフローではwrite action safetyを使うこと、送信、編集、投稿、削除などの操作ではwrite approvalsを慎重に扱うことが説明されています。
また、Connector Action Constraintsにより、エージェントがコネクタに依頼できる操作を特定条件に絞る考え方も示されています。
これは、発注者が検収時に見るべき観点と近いものです。
検収では、次のようなテストケースを入れます。
承認なしでメール送信やCRM更新をしようとしたとき、実行が止まるか
承認者、承認日時、承認内容、実行結果がログに残るか
承認内容と実際の実行内容が一致しているか
権限外の顧客、案件、部門データを参照しようとしたとき、拒否されるか
誤った指示、曖昧な指示、危険な指示を受けたとき、人間確認へ戻せるか
失敗時に、再試行、停止、通知、手動復旧の手順が決まっているか
ここまで見ると、AIエージェントの検収は「AIが正しく答えるか」ではなく、「AIが業務上許された範囲で動いたか」を確認する作業になります。
発注者側にとっては、これが本番導入の承認材料になります。
ログは後から読める粒度で残す
監査ログは、単に保存されていればよいわけではありません。
後から、誰が、いつ、どの入力をし、AIが何を参照し、どのツールを呼び、どの操作を実行し、結果がどうなったかを読める必要があります。
AIの回答文だけを残しても、問題発生時に原因を追えません。
NSAは2026年5月20日のMCPに関するセキュリティ設計資料で、AIがツールを動的に呼び出すこと、暗黙の信頼関係、文脈共有が新しいリスクになると説明しています。
この指摘は、発注者にとっても重要です。
AIエージェントを外注する場合、実装が高度になるほど、ログ、権限、承認、文脈共有を後から説明できる状態にしておく必要があります。
関連記事
企業のAI導入は、ツールを入れる前に、対象業務、データ、権限、KPI、運用責任を決めなければ成果につながりません。 本記事では、AI導入が失敗する原因を分解し、PoC前に企業が決めるべき進め方を実務視点で整理します。
権限を渡しすぎたときの失敗パターン
AIエージェントのリスクは、AIが間違えることだけではありません。
間違えたときに、どの権限で何を実行できてしまうかが問題です。
発注者は、起き得る失敗を先に想定し、検収テストへ入れておく必要があります。
よくある失敗は、権限外情報の参照です。
たとえば、一般社員向けの社内問い合わせエージェントが、人事評価、候補者情報、契約条件、特定顧客の価格表を回答に混ぜるケースです。
元文書を直接表示しなくても、AIが要約してしまえば情報漏えいに近い問題になります。
次に、誤更新です。
AIがチケットのステータス、CRMの商談確度、請求の処理状況、社内タスクの期限を誤って更新すると、後工程に影響します。
人間なら気づく違和感でも、AIエージェントが一括で処理すると、複数件に同じ誤りが広がる可能性があります。
さらに、承認前の業務実行があります。
顧客への返信、外部共有リンクの作成、発注書の送付、支払処理、通知の一斉送信などは、誤操作の影響が外部に出ます。
この領域では、AIが下書きすることと、実際に送ることを分けるべきです。
暴走ではなく権限設計の失敗として見る
AIエージェントの事故は、「AIが暴走した」という表現で片づけられがちです。
しかし、発注者が検収で見るべきなのは、AIの性格ではありません。
権限を渡しすぎていないか、承認なしで実行できないか、曖昧な指示を拒否できるか、ログで追えるかです。
AIが予定外の操作をした場合でも、読み取り専用なら影響は限定されます。
承認付き実行なら、人間が止められる可能性があります。
強い権限を自律実行に渡すなら、金額上限、対象範囲、時間帯、件数、承認者、停止条件を細かく設定する必要があります。
発注者は、AIエージェントを信用するかどうかではなく、失敗しても業務被害が広がらない設計になっているかを確認してください。
ベンダーへ確認すべき質問
AIエージェント開発を外注する場合、発注者は実装方式の細部まで指定する必要はありません。
一方で、確認すべき質問を持たずにベンダーへ任せると、画面やデモの完成度に評価が寄りやすくなります。
外注前と検収前には、次の質問を使ってください。
質問 | 見たい答え | 注意すべき回答 |
|---|---|---|
AIは誰の権限で操作しますか | ユーザー権限、サービスアカウント、スコープの説明 | 管理者権限でまとめて動かす |
書き込み操作はどこで止まりますか | 承認者、承認画面、ログが決まっている | AIが判断して実行するだけ |
権限外データをどう拒否しますか | 元データ権限と回答前チェックがある | プロンプトで禁止しているだけ |
接続先追加は誰が承認しますか | 変更管理と履歴がある | ベンダー側で随時追加できる |
障害や誤操作時に何を見ますか | 入力、参照、実行、結果のログがある | チャット履歴しか残らない |
特に注意したいのは、「プロンプトで禁止しています」という説明だけで済ませるケースです。
プロンプトは重要ですが、権限管理そのものではありません。
AIが見られないデータはシステム側で見られないようにし、実行できない操作は権限と承認で止める必要があります。
Phinxが見るコンテキストと実行権限の分離
PhinxがAI-nativeな開発支援で重視するのは、AIに与える文脈と、AIに許す実行権限を分けることです。
これは、実装者向けにはコンテキストやツール呼び出しの設計問題ですが、発注者向けには検収項目として扱うべきです。
AIにどの業務文脈を渡すか。
どのデータを参照させるか。
どのツールを使わせるか。
どの操作は人間承認を必須にするか。
どのログを残すか。
この分解があると、発注者は「AIが賢いか」ではなく「業務上許された範囲で動いているか」を検収できます。
具体的な内部設計や顧客事例を開示しなくても、発注者はこの考え方を持ってベンダーと会話できます。
AIエージェント外注では、実装の自由度を残しながら、業務責任と検収基準を明確にすることが重要です。
まとめ
AIエージェント開発を外注するときは、最初から高度な自律実行を目指す必要はありません。
まず、対象業務を決め、AIが読む情報、作る下書き、人間承認後に実行する操作、自律実行させる範囲を分けることが先です。
そのうえで、認証認可、接続先、承認フロー、監査ログ、停止条件を発注範囲と検収項目に入れてください。
発注者が確認すべきなのは、AIがそれらしい回答を返すことだけではありません。
権限外の情報を見ないこと、許可されていない操作をしないこと、危険な操作では人間に戻すこと、問題が起きたときにログで追えることです。
この基準があると、AIエージェント外注はデモで終わらず、本番業務へ進めやすくなります。
Phinx(フィンクス)は、業務整理、データ基盤、既存システム連携、AI-native開発、導入後の運用定着を一体で見られる体制を持っています。
AIエージェントに任せる業務と渡す権限を分け、発注者が検収できる形へ落とし込める点がPhinxの強みです。
出典
Model Context Protocol Blog「The 2026-07-28 Specification」 https://blog.modelcontextprotocol.io/posts/2026-07-28/
Model Context Protocol Blog「The New MCP Roadmap」 https://blog.modelcontextprotocol.io/posts/mcp-roadmap/
NSA「Security Design Considerations for AI-Driven Automation Leveraging the Model Context Protocol」 https://www.nsa.gov/Press-Room/Press-Releases-Statements/Press-Release-View/Article/4496698/nsa-releases-security-design-considerations-for-ai-driven-automation-leveraging/
Microsoft Learn「Secure a Model Context Protocol (MCP) server with Microsoft Entra ID」 https://learn.microsoft.com/en-us/entra/agent-id/secure-mcp-server-with-entra-id
OpenAI Help「ChatGPT Workspace Agents for Enterprise and Business」 https://help.openai.com/en/articles/20001143-chatgpt-workspace-agents-for-enterprise-and-business
Stay up-to-date
関連記事